Fra dokumentchat til videnassistent: Sådan får du bedre svar med kilder

Skrevet af Kåre Bjørn Jensen assisteret af AI
En AI-assistent kan søge i organisationens dokumenter og svare med kildehenvisninger. Men kvaliteten afhænger af, hvilke oplysninger den finder, hvordan materialet er organiseret, og om svarene bliver kontrolleret. Her er fem principper, der hjælper dig fra en overbevisende demonstration til en brugbar løsning.
Mange har allerede prøvet at »chatte med deres dokumenter«. Det virker godt, når assistenten finder den rigtige vejledning og forklarer den klart. Problemerne viser sig, når dokumentsamlingen også indeholder dubletter, gamle versioner og procedurer, der kun gælder for bestemte afdelinger.
Forestil dig, at du spørger til virksomhedens regler for hjemmearbejde. Assistenten finder en personalepolitik og giver et klart svar med en kildehenvisning. Men dokumentet er fra sidste år, og reglerne er siden ændret.
Svaret kan være tro mod dokumentet og alligevel forkert i den aktuelle situation.
Det er en af udfordringerne ved RAG, en forkortelse for Retrieval-Augmented Generation. Princippet er, at systemet først søger efter relevante oplysninger i en dokumentsamling og derefter giver de fundne tekststykker til en sprogmodel, som formulerer svaret. Hvis løsningen er indrettet til det, kan den også vise, hvilke dokumenter oplysningerne kommer fra.
RAG kan gøre svar bedre forankret i organisationens materiale. Men metoden garanterer hverken, at systemet finder de rigtige kilder, eller at modellen bruger dem korrekt.
1. Gør det muligt at finde den rigtige viden
En videnassistent begynder med søgning. Derfor skal dokumenterne organiseres, så systemet kan finde de oplysninger, der faktisk besvarer spørgsmålet.
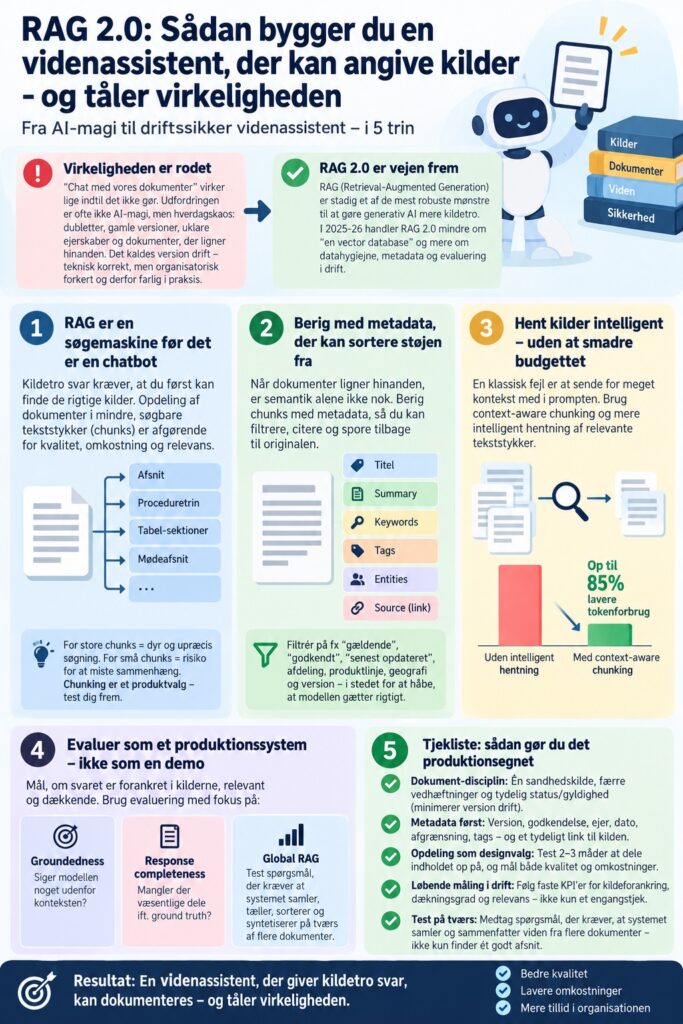
Dokumenter bliver ofte delt op i mindre tekststykker, også kaldet chunks. Det gør det muligt at hente et relevant afsnit frem for at sende en hel håndbog til modellen.
Opdelingen påvirker både søgningens kvalitet og mængden af tekst, modellen skal behandle. Store tekststykker kan indeholde meget irrelevant indhold. Små tekststykker kan miste vigtig sammenhæng – eksempelvis en undtagelse til den regel, de beskriver. Microsofts arkitekturvejledning anbefaler derfor at afprøve forskellige opdelingsmetoder på det konkrete materiale. [1]
En procedure kan med fordel følge sine trin. Et referat kan følge dagsordenspunkterne. En tabel kan kræve, at kolonneoverskrifter og forklaringer følger med tallene.
Der findes ikke én størrelse, der passer til alle dokumenter. Test opdelingen med spørgsmål, som brugerne faktisk vil stille.
2. Brug metadata til at skelne mellem dokumenterne
To dokumenter kan ligne hinanden sprogligt og gælde for helt forskellige situationer. Derfor er søgning efter indholdets betydning ikke altid tilstrækkelig.
Metadata er oplysninger om dokumenterne og deres indhold. Det kan være titel, afdeling, versionsnummer, godkendelsesstatus og gyldighedsdato. Oplysningerne kan bruges til at afgrænse søgningen, så assistenten eksempelvis kun henter gældende vejledninger for den relevante afdeling.
Microsoft beskriver også, hvordan tekststykker kan beriges med blandt andet resuméer, nøgleord og kildeoplysninger. Hvilke felter der er nyttige, afhænger af materialet og de spørgsmål, løsningen skal besvare. [2]
Et forskningsstudie med titlen Utilizing Metadata for Better Retrieval-Augmented Generation viser, at bestemte metoder til at integrere metadata kan forbedre søgningen i strukturerede dokumentsamlinger med gentagende formuleringer. Resultaterne understøtter brugen af metadata, men er ikke en garanti for samme forbedring i enhver organisation. [3]
I eksemplet med hjemmearbejde skal systemet kunne skelne mellem den gamle og den gældende politik. En opdateringsdato kan hjælpe, men er ikke nødvendigvis nok: Det senest redigerede dokument kan stadig være et udkast.
Metadata skal derfor vedligeholdes. Et felt med teksten »godkendt« hjælper kun, hvis nogen har ansvar for, at oplysningen er korrekt.
3. Hold øje med både svarkvalitet og omkostninger
Når en sprogmodel behandler tekst, opdeles teksten i små enheder, der kaldes tokens. Mængden af tekst har betydning for modellens forbrug og typisk også for prisen.
Det kan derfor være en fordel at hente få relevante tekststykker frem for at sende hele dokumenter med hvert spørgsmål.
I et teknisk blogindlæg illustrerer Microsoft en reduktion i tokenforbruget på omkring 80–85 procent ved at sammenligne en prompt med et helt dokument med en løsning, der kun sender få udvalgte tekststykker til modellen. [4]
Det er et leverandøreksempel, som viser princippet. Det dokumenterer ikke, at en bestemt opdelingsmetode generelt sparer 85 procent sammenlignet med andre RAG-løsninger.
Desuden omfatter driften mere end modellens tekstforbrug. Dokumenterne skal behandles, søgningen skal fungere, og materialet skal holdes opdateret.
Mål derfor både kvalitet og samlet forbrug. Et billigt svar har begrænset værdi, hvis det udelader den afgørende undtagelse. Omvendt er det sjældent hensigtsmæssigt at sende en hel håndbog med for at besvare et spørgsmål om ét afsnit.
4. Kontrollér, hvad kildehenvisningen faktisk dokumenterer
En kildehenvisning gør det lettere at efterprøve et svar. Men henvisningen er ikke i sig selv et kvalitetsstempel.
Dokumentet kan eksistere uden at understøtte påstanden. Svaret kan gengive en hovedregel og overse en undtagelse. Eller kilden kan være forældet.
Evalueringen bør derfor skelne mellem flere spørgsmål:
- Finder systemet de relevante oplysninger?
- Er svarets påstande understøttet af de fundne kilder?
- Besvarer det brugerens spørgsmål?
- Er væsentlige oplysninger og forbehold kommet med?
Microsofts vejledning om RAG-evaluering skelner tilsvarende mellem søgekvalitet, kildeforankring, relevans og fuldstændighed. Fuldstændighed kan eksempelvis vurderes ved at sammenligne svaret med et fagligt kontrolleret referencesvar. [5]
Lav et sæt realistiske testspørgsmål med kendte svar. Medtag også spørgsmål, hvor dokumenterne modsiger hinanden, eller hvor materialet ikke indeholder et tilstrækkeligt svar.
Assistenten skal kunne gøre opmærksom på manglende grundlag frem for at udfylde hullerne med en overbevisende formulering.
Gentag testene, når dokumenter, søgemetoder eller modeller ændres.
5. Test spørgsmål på tværs af dokumentsamlingen
Det er én opgave at finde et afsnit om hjemmearbejde. Det er en anden at besvare: »Hvilke afdelinger har ændret deres regler det seneste år?«
Det sidste spørgsmål kræver, at systemet identificerer relevante dokumenter, sammenligner versioner og skaber et overblik. En søgning, der kun returnerer nogle få gode tekststykker, kan overse materiale, der er nødvendigt for et dækkende svar.
Forskerne bag GlobalQA-benchmarket undersøger netop opgaver på tværs af hele dokumentsamlinger, blandt andet optælling, sortering og udvælgelse af de højest placerede resultater. De finder store udfordringer for de undersøgte RAG-metoder på benchmarkets opgaver. [6]
Det betyder ikke, at alle videnassistenter fejler på samme måde. Det betyder, at evnen til at besvare spørgsmål om enkelte afsnit ikke dokumenterer evnen til at skabe et fuldstændigt overblik.
Test derfor begge typer spørgsmål, hvis brugerne har brug for dem. Og afklar, om nogle opgaver kræver mere systematisk databehandling eller særskilte beregninger.
Tjekliste: Før videnassistenten bliver en del af hverdagen
- Afklar kilderne. Hvilke dokumenter er autoritative, og hvem har ansvar for at holde dem opdateret?
- Vedligehold metadata. Registrér relevante oplysninger om version, gyldighed, godkendelse og anvendelsesområde.
- Respektér adgangsrettigheder. Søgningen skal afgrænses, så brugerne kun får oplysninger, de må tilgå.
- Planlæg opdatering og sletning. Ændringer skal slå igennem i søgeindekset og eventuelle mellem-lagre.
- Test med realistiske spørgsmål. Medtag undtagelser, modstridende kilder og spørgsmål uden svar.
- Kontrollér henvisningerne. Kilden skal understøtte den konkrete påstand, og brugeren skal kunne finde det relevante sted.
- Følg kvalitet og omkostninger. Gentag evalueringen, når løsningen eller materialet ændres.
En brugbar videnassistent kræver både søgning, dokumentansvar og løbende kontrol. Når den kombination fungerer, bliver det lettere for medarbejderne at finde relevant viden og undersøge grundlaget for svaret.
Kildehenvisningen er en hjælp til den undersøgelse. Den erstatter den ikke.
Kilder
[1] Microsoft Learn, Azure Architecture Center: RAG chunking phase.
https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/rag/rag-chunking-phase
[2] Microsoft Learn, Azure Architecture Center: RAG chunk enrichment phase.
https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/rag/rag-enrichment-phase
[3] Raquib Bin Yousuf m.fl.: Utilizing Metadata for Better Retrieval-Augmented Generation. 2026. Forskningsartikel med arXiv-version og angivelse af ECIR 2026.
https://arxiv.org/abs/2601.11863
[4] Microsoft Community Hub: Context-Aware RAG System with Azure AI Search to Cut Token Costs and Boost Accuracy. 23. oktober 2025. Teknisk blogindlæg og leverandøreksempel.
https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/context-aware-rag-system-with-azure-ai-search-to-cut-token-costs-and-boost-accur/4456810
[5] Microsoft Learn: Retrieval-Augmented Generation (RAG) Evaluators for Generative AI.
https://learn.microsoft.com/en-us/azure/foundry/concepts/evaluation-evaluators/rag-evaluators?view=foundry
[6] Qi Luo m.fl.: Towards Global Retrieval Augmented Generation: A Benchmark for Corpus-Level Reasoning. 2025. Forskningsmanuskript på arXiv, version 2.
https://arxiv.org/abs/2510.26205
Medlem
80 kr./måned
Bliv medlem på PatreonStøt AI-Portalens uafhængige journalistik om AI, magt og samfund.
Inkluderet i medlemskabet:
- Månedligt nyhedsbrev
- Invitationer til online og fysiske events om AI
- Adgang til optagelser og opsamlinger fra møder og foredrag
- Rabat på events
- Invitation til månedligt online redaktionsmøde
Medlemskab administreres via Patreon.
Vi laver journalistik om AI, fordi udviklingen går hurtigere end den offentlige samtale.
På AI Portalen forsøger vi at skabe overblik, perspektiv og kritisk indsigt i en teknologi, der allerede former alt fra arbejdsmarkedet til demokratiet — ofte uden at nogen bremser op og forklarer, hvad der foregår.
Hvis vores artikler hjælper dig med at forstå AI lidt bedre, så overvej at støtte arbejdet.
Et medlemskab gør én ting mulig: at vi kan blive ved med at undersøge, dokumentere og forklare, hvordan AI påvirker Danmark — uden investorer, uden PR-interesser og uden at jage hype.
Bliv medlem og vær med til at styrke uafhængig journalistik om AI.
Follow Me